日本語の文章を、別のAIに読ませるとどう評価するのでしょうか。
Sarashina(さらしな)は、SB Intuitionsが開発する、日本語のデータを重点的に学習したAIモデルのシリーズです。文章の作成や会話などに利用でき、日本語の扱いに力を入れている点が特徴です。APIを通じて、別のソフトから呼び出すこともできます。Sarashina公式サイト
今回はSarashina APIを使い、私が公開しているコラム「『いずい』は『いずい』なんです」を採点してもらいました。
さらに、CodexとSarashinaでそれぞれ修正案を作り、その2案を比較してみました。
試して分かったのは、Sarashinaは日本語の文章を読み、筋の通った講評を書く一方で、講評の内容まで正確とは限らないということです。
そして、文章を読みやすく直してもらったつもりが、伝えたい意味まで少し変わってしまう場面もありました。
「いずい」のコラムを読ませてみた
今回使ったモデルは、sarashina3-miniです。CodexからSarashina APIを呼び出し、公開記事の本文を渡しました。
APIは、別のソフトからサービスを呼び出すための窓口です。今回は、記事の本文と採点の指示を送り、回答を受け取る形で利用しました。公式ドキュメント
対象に選んだのは、「いずい」という方言から、言葉を正確に使うことについて考えたコラムです。
「いずい」を標準語にすれば、「違和感がある」が近いと思います。
でも、それだけでは足りない。
辞書的には間違っていなくても、自分が感じていることを正確に表しているとは限らない。これは、AIに文章を書いてもらうときにも起こるのではないか、という内容です。
言葉の微妙な違いを扱った文章なので、Sarashinaがどのように読むのか試してみることにしました。
最初の採点は、Codexが90点、Sarashinaが91点
まず、元の記事をCodexとSarashinaにそれぞれ採点してもらいました。
評価項目は、明瞭さ、構成、言葉の精度、説得力、文章の魅力の5つ。各20点、合計100点です。
結果は、Codexが90点、Sarashinaが91点でした。
合計は近いものの、評価の内訳は異なります。Codexは明瞭さと言葉の精度を高く評価し、Sarashinaは構成と文章の魅力を高く評価しました。
まず、元記事の採点結果を図にまとめました。
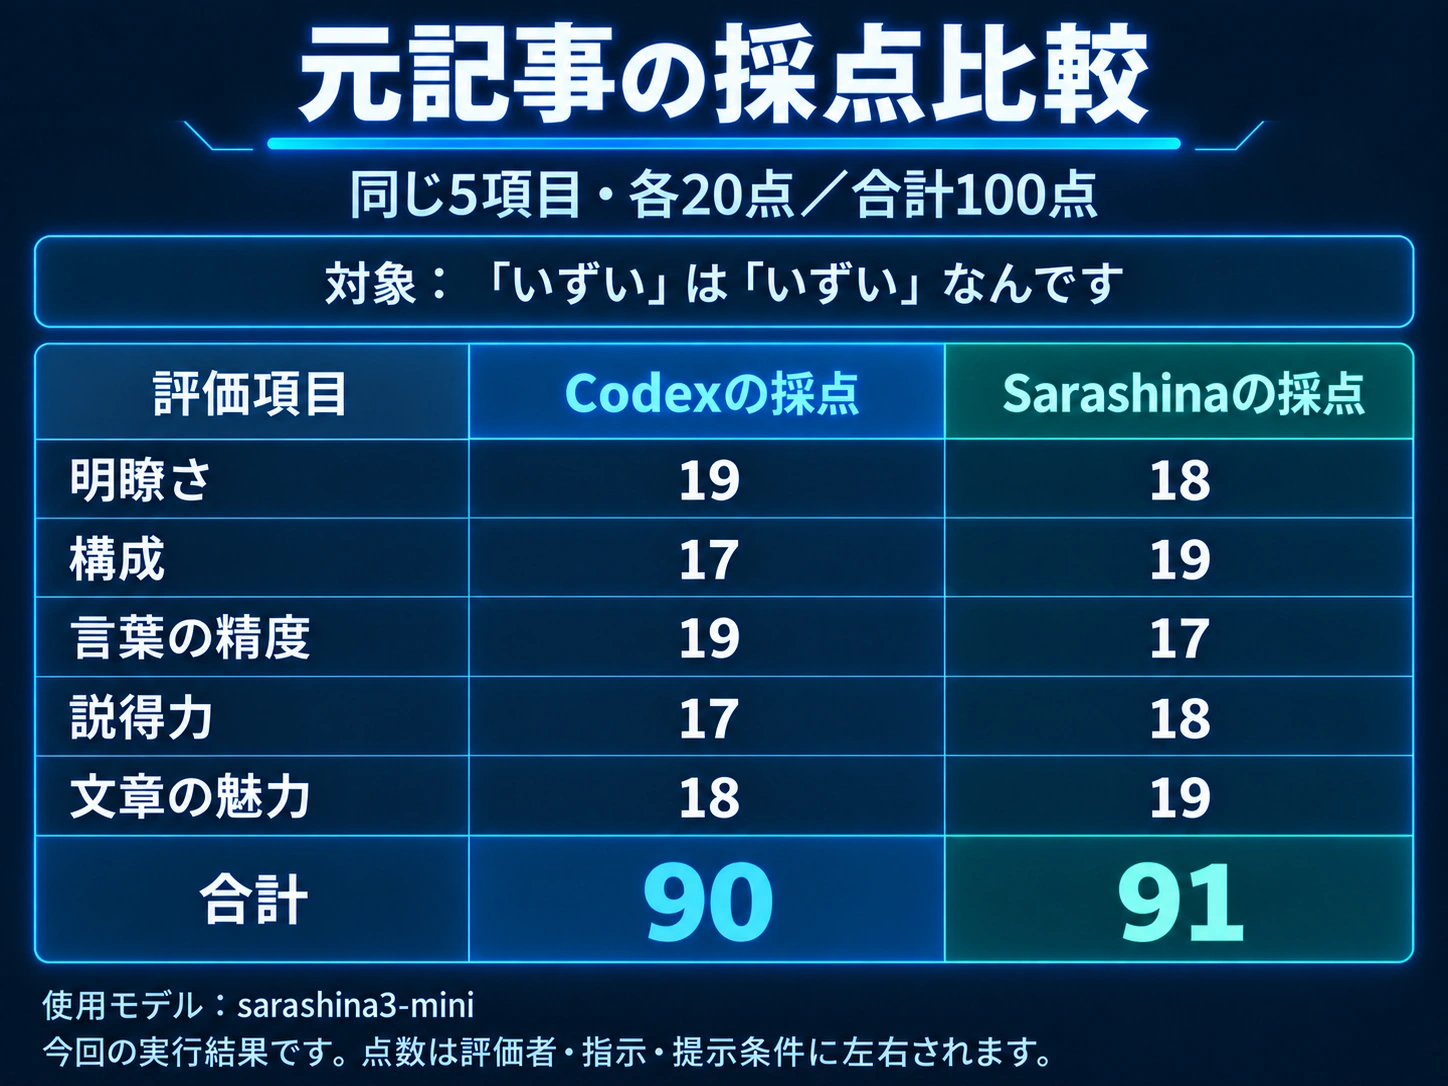
Sarashinaは、身近な具体例や、親しみやすい語り口、「いずいはいずいんです」という反復を評価してくれました。
点数だけでなく、項目ごとに理由を説明してくれるので、自分の文章を見直す材料にはなります。
ただ、改善点を読んでいくと、そのまま受け入れてよいのか迷う指摘もありました。
例えば、言葉の辞書的な意味や文化的背景を、もう少し掘り下げた方がよいという意見です。
説明を増やせば詳しくはなるでしょう。しかし、このコラムで伝えたいのは、言葉についての知識を網羅することではありません。
説明を足すことが、そのまま文章の改善になるとは限らないと思います。
CodexとSarashinaで修正案を作った
次に、同じ原文を基に、CodexとSarashinaで修正案を作りました。
本人の体験や主張を変えず、「いずいはいずいんです」という反復も残す。主に後半の重複を整理する、という方針です。
Codex案では、方言を別の言葉に置き換える難しさと、仕事の指示を曖昧に伝える問題を分け、その間をつなぐ説明を補いました。
一方、Sarashinaが最初に返した案は、原文とほぼ同じでした。
そこで、後半3節を対象に、重複を減らして実際に推敲するよう、もう一度依頼しました。比較に使ったSarashina案は、この再依頼で作られたものです。
同じ文章を基にしていますが、修正の進め方まで同一条件だったわけではありません。
読みやすくなっても、意味が変わることがある
Sarashina案は、短い文が増え、歯切れのよい文章になりました。
ただし、気になる変更もあります。
原文では、AIに「いずい」を標準語にするよう頼んだ場合について、こう書いていました。
「違和感がある」と回答するかもしれません。
Sarashina案では、次のようになっています。
「違和感がある」と答えるでしょう。
「かもしれません」と「でしょう」。
わずかな違いですが、確かさの程度が変わっています。もともとは仮の例として書いたものが、より確実な回答として読める表現になりました。
もう一つあります。
原文の「相手ができるだけ誤解せずに理解できる言葉で表現したい」は、Sarashina案では「相手にそのまま届く言葉で話したい」になっていました。
簡潔で、印象に残る言い方です。
でも、私が書いているのは、言葉が相手にそのまま届くとは限らないから、ずれを少しでも小さくしたい、という話です。
「できるだけ誤解せずに」と「そのまま届く」は、同じではありません。
文章を整えてもらうときには、こうした変更も確かめる必要があります。
修正案をCodexに採点してもらった
2つの修正案を、まずCodexに同じ5項目で採点してもらいました。
結果は、Codex案が92点、Sarashina案が88点です。
Codexは、自分の修正案について、方言の置き換えと仕事の指示の曖昧さを分けたことで、話のつながりが改善したと評価しました。
Sarashina案については、歯切れがよくなった一方で、断定の強さやニュアンスが変わったことを減点理由に挙げています。
ただし、Codexが自分で書いた案を自分で評価している点には注意が必要です。
自分が意図して直した部分を、よい変更として評価することも考えられます。この採点だけで、どちらを採用するか決めるつもりはありません。
作者名を伏せて、Sarashinaにも採点してもらった
そこで、Sarashinaにも2案の採点を依頼しました。
今度は、どちらがCodex案で、どちらがSarashina案なのかを伏せています。それまでの点数や、Codexによる比較評価も伝えていません。
結果は、Codex案が97点、Sarashina案が94点でした。
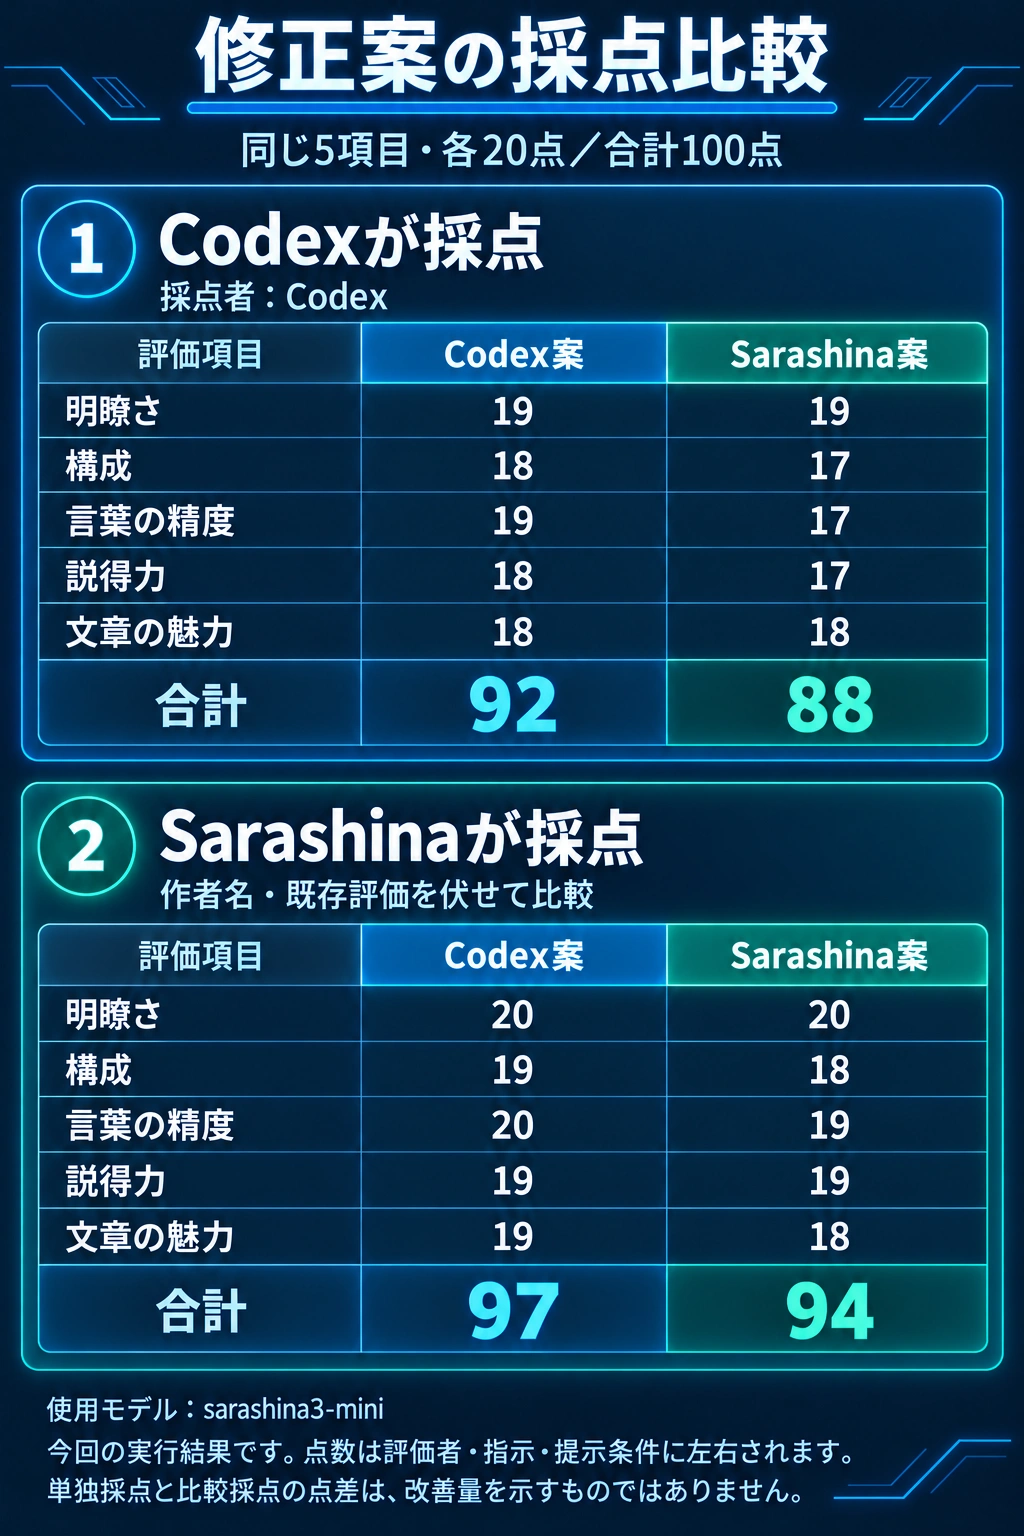
Sarashinaも、構成の自然さと言葉の精度を理由に、Codex案を選びました。
ただし、これでCodexの日本語力がSarashinaより高いと結論づけることはできません。
一つのコラムについて、今回の指示と出力で比較した結果です。作者名は伏せましたが、提示順を入れ替えた再評価や、複数回の採点はしていません。
また、元記事の採点は単独で、修正案の採点は2案を並べて行っています。
元記事の91点から修正案の97点になったからといって、文章が6点分よくなったと考えることもできません。
同じ5項目を使っていても、採点の状況まで同じではないのです。
講評にも読み違いがあった
採点理由を読むと、もっともらしく書かれていても、本文と合わない指摘がありました。
例えば、SarashinaはCodex案について、ある見出しの「挿入位置」を評価しています。
しかし、その見出しの順番は両案で同じです。変わったのは、その節の冒頭にある説明でした。
また、Sarashina案にはAIへの修正指示の例が書かれているのに、講評では「具体例があれば、より説得力が増した」と指摘しています。
例が足りないという評価なら分かります。でも、例があることを踏まえた説明にはなっていませんでした。
点数表があり、理由も丁寧に書かれている。
それだけで、正確に読んでもらえたように感じてしまいます。
しかし、評価する側の文章についても、元の文章と照らし合わせる必要がありました。
日本語力を試したら、言葉を確かめる話に戻ってきた
今回の範囲では、Sarashinaは日本語の文章を読み、構成や語り口について講評し、修正案を出す相手として使えると感じました。
一方で、採点理由に読み違いがあり、推敲では断定の強さやニュアンスが変わることもありました。
APIの反応速度は、まぁまぁ。これは今回使った体感で、厳密に時間を測って比較したわけではありません。
ただ、まだ実用するには怖い気がする、というのが率直な感想です。文章は自然に読めるのに、よく見ると意味が変わっていたり、講評が本文と合っていなかったりする。そのまま仕事に使うには、気になります。
高得点だったから、その文章を採用する。
読みやすくなったから、その修正を受け入れる。
それだけでは、自分が伝えたいことから離れてしまう場合があります。
今回試した元記事には、こう書いていました。
文章が自然に読めることと、伝えたいことが正確に伝わることは、同じではありません。
Sarashinaの日本語力を試してみたら、結局、この一文に戻ってきました。
AIが選んだ言葉を、自分はその意味で使いたいのか。
点数を見ることより、その確認の方が、私には大切だと思います。
※Sarashinaの使用モデルは「sarashina3-mini」です。今回の結果は、一つのコラムを使った試行であり、モデル全体の能力を測る標準的な試験ではありません。このコラムの原稿はCodexで作成しています。
関連リンク
- 理解:API・API連携